
Implementar un VPS Linux de alto rendimiento requiere ajustar los parámetros del núcleo, los búferes de red y los parámetros del sistema de archivos. En esta guía operativa, revisamos el control de congestión Google BBRv3, el dimensionamiento de los búferes de sockets TCP, los umbrales de intercambio de memoria virtual (swapping) y la optimización del almacenamiento flash NVMe para servidores web de producción.
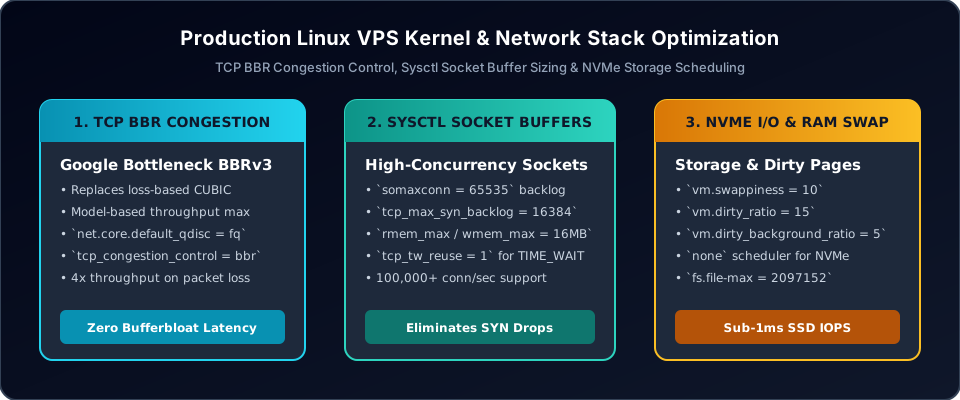
1. Activación del control de congestión Google BBRv3
Los algoritmos de congestión TCP tradicionales (como CUBIC) tratan la pérdida de paquetes como el único indicador de congestión en la red, lo que provoca que el rendimiento colapse en conexiones transatlánticas o celulares. Google BBR (Bottleneck Bandwidth and Round-trip propagation time) construye un modelo físico dinámico de la tubería de red, maximizando el rendimiento mientras mantiene los retrasos en las colas cerca de cero.
# Enable Fair Queuing and BBR in /etc/sysctl.conf
net.core.default_qdisc = fq
net.ipv4.tcp_congestion_control = bbr
Para verificar que BBR se encuentra activo en el núcleo de Linux en ejecución, ejecute:
sysctl net.ipv4.tcp_congestion_control
lsmod | grep bbr
2. Ajuste de búferes de sockets de alta concurrencia
Para eliminar la caída de conexiones durante picos de tráfico, amplíe el backlog de escucha de sockets, los límites de seguimiento de conexiones y las asignaciones de búferes de memoria en /etc/sysctl.conf:
# Socket Backlogs
net.core.somaxconn = 65535
net.ipv4.tcp_max_syn_backlog = 16384
net.core.netdev_max_backlog = 16384

# TCP Buffer Allocations (Min / Default / Max in bytes)
net.ipv4.tcp_rmem = 4096 87380 16777216
net.ipv4.tcp_wmem = 4096 65536 16777216
net.core.rmem_max = 16777216
net.core.wmem_max = 16777216

# Socket Reuse & File Descriptors
net.ipv4.tcp_tw_reuse = 1
net.ipv4.tcp_fin_timeout = 15
fs.file-max = 2097152
Estos valores garantizan que el núcleo pueda almacenar en búfer grandes ráfagas de conexiones HTTP/HTTPS entrantes sin terminar prematuramente los apretones de manos (handshakes) ni descartar paquetes SYN bajo una concurrencia pico.
3. E/S de almacenamiento NVMe & e intercambio de memoria (Swappiness)
Para el almacenamiento flash NVMe moderno, la puesta en cola de E/S del núcleo añade una sobrecarga de CPU innecesaria. Configure el planificador de almacenamiento en none y ajuste el vaciado de páginas sucias (dirty pages):
# Virtual Memory & Swappiness Tuning
vm.swappiness = 10
vm.dirty_ratio = 15
vm.dirty_background_ratio = 5
vm.vfs_cache_pressure = 50
Aplique los cambios inmediatamente sin reiniciar mediante sudo sysctl -p. Para unidades de estado sólido (SSD) y dispositivos de bloques NVMe PCIe, verifique el planificador activo inspeccionando:
cat /sys/block/nvme0n1/queue/schedulerLa salida debe indicar [none] o [mq-deadline] para asegurar un envío de hardware de múltiples colas directo y de baja sobrecarga.
4. Límites de descriptores de archivos Systemd & PAM (nofile)
Un modo de fallo común en instancias web con mucho tráfico es el notorio socket: too many open files (errno 24). Incluso si fs.file-max está ajustado a millones en sysctl, los procesos de Linux están limitados por las restricciones de usuario de PAM y los límites de las unidades de servicio de Systemd.
Configure límites persistentes a nivel de sistema en /etc/security/limits.conf:
* soft nofile 65536
* hard nofile 1048576
root soft nofile 65536
root hard nofile 1048576
Para servicios administrados por Systemd (como Nginx, Redis o Node.js), edite la anulación de la unidad de servicio o /etc/systemd/system.conf:
[Service]
LimitNOFILE=65536
LimitNPROC=65536
Recargue el demonio de systemd con sudo systemctl daemon-reload y reinicie el servicio para aplicar los límites aumentados de descriptores de archivos.
5. Ajuste de la interfaz de red con Ethtool & y búferes circulares (Ring Buffers)
Las instancias de servidores virtuales que procesan un alto tráfico de E/S de red pueden descartar paquetes entrantes antes de que lleguen a la pila de red del núcleo si los búferes circulares de la interfaz están configurados con valores conservadores predeterminados.
Utilice ethtool para inspeccionar y maximizar los búferes circulares de RX/TX:
# Query maximum and current ring buffer sizes
sudo ethtool -g eth0

# Expand RX and TX ring buffers to device maximums
sudo ethtool -G eth0 rx 4096 tx 4096

# Verify hardware offloading features (TSO, GSO, GRO)
sudo ethtool -k eth0 | grep -E "tcp-segmentation-offload|generic-receive-offload"
Asegurar que TCP Segmentation Offload (TSO) y Generic Receive Offload (GRO) estén habilitados permite que la tarjeta de red agrupe los paquetes, reduciendo significativamente las interrupciones de la CPU en cargas de trabajo de alto rendimiento.
6. Pruebas comparativas empíricas & y conjunto de verificación
Valide las optimizaciones del núcleo con pruebas empíricas antes y después de aplicar los cambios. Ejecute estas herramientas de línea de comandos verificadas:
# Test raw network throughput and latency across multiple TCP streams
iperf3 -c benchmark.winwinhost.com -P 8 -t 30

# Benchmark NVMe random 4K read/write IOPS and latency under direct I/O
fio --name=randwrite --ioengine=libaio --iodepth=64 --rw=randwrite \
    --bs=4k --direct=1 --size=2G --runtime=30 --numjobs=4 --group_reporting

# Monitor virtual memory, page faults, and context switches in real time
vmstat 1 10

# Audit disk I/O utilization and wait queues per device
iostat -xz 1 5
Preguntas frecuentes
¿Por qué TCP BBR es superior a Cubic en enlaces de larga distancia o con pérdida de paquetes?
TCP Cubic asume que la pérdida de paquetes indica congestión y reduce la ventana de transmisión a la mitad cada vez que se pierde un paquete. En enlaces transatlánticos o Wi-Fi donde la pérdida menor de paquetes es rutinaria, Cubic ahoga el rendimiento de la red. BBR mide continuamente el tiempo real de ida y vuelta (RTT) y la tasa de entrega, manteniendo el rendimiento de la línea completa incluso con un 1-2% de pérdida de paquetes en segundo plano.
¿Qué hace la configuración vm.swappiness = 10 en comparación con 0?
Configurar vm.swappiness = 0 evita agresivamente el intercambio (swapping) hasta que el sistema se queda completamente sin RAM, lo que puede activar el asesino de falta de memoria (OOM killer) del núcleo prematuramente durante picos repentinos de memoria. Un valor de 10 indica al núcleo que prefiera recuperar la caché de páginas del sistema de archivos mientras permite que el espacio de intercambio absorba de forma segura los picos transitorios de memoria.
¿Cómo puedo verificar que las configuraciones de sysctl persisten a través de los reinicios del núcleo?
Almacene todas las configuraciones en archivos dedicados de inclusión (drop-in) como /etc/sysctl.d/99-custom-tuning.conf. Cuando el servidor arranca, systemd-sysctl.service carga todos los archivos en /etc/sysctl.d/ en orden alfabético, asegurando que los valores no sean sobrescritos por los paquetes predeterminados de la distribución.
¿Cuándo debo elegir mq-deadline en lugar de none para la programación de almacenamiento?
Para unidades NVMe empresariales PCIe 4.0/5.0 capaces de múltiples colas por hardware, el planificador none ofrece la menor sobrecarga de CPU. Para SSDs SATA o dispositivos de bloques virtualizados virtio con matrices de almacenamiento compartidas, mq-deadline previene la inanición de E/S aplicando plazos delimitados para solicitudes de lectura y escritura.
Resumen & VPS en la nube de alto rendimiento
Ajustar el núcleo de Linux transforma una instancia virtual estándar en un motor de alta concurrencia capaz de manejar decenas de miles de conexiones HTTP/HTTPS simultáneas. Al combinar Google BBR, búferes de sockets ampliados, intercambio de memoria optimizado y límites de descriptores de archivos adecuados, los servidores en la nube logran un rendimiento máximo con tiempos de respuesta inferiores a un milisegundo.
Servidores en la nube NVMe de alto rendimiento
Implemente instancias en la nube Linux optimizadas impulsadas por almacenamiento NVMe PCIe 4.0, núcleos de CPU dedicados y tránsito de red prémium de Nivel 1 en WinWinHost.
Explorar planes de VPS en la nube →