
उच्च-थ्रूपुट Linux VPS को तैनात करने के लिए कर्नेल पैरामीटर, नेटवर्क बफ��� और फ़ाइल सिस्टम पैरामीटर को ट्यून करने की आवश्यकता होती है। इस परिचालन मार्गदर्शिका में, हम समीक्षा करते हैं Google BBRv3 कंजेशन नियंत्रण, TCP सॉकेट बफर साइज़िंग, वर्चुअल मेमोरी स्वैपिंग थ्रेशोल्ड, और प्रोडक्शन वेब सर्वर के लिए NVMe फ्लैश स्टोरेज ऑप्टिमाइज़ेशन।
1. Google BBRv3 कंजेशन नियंत्रण को सक्रिय करना
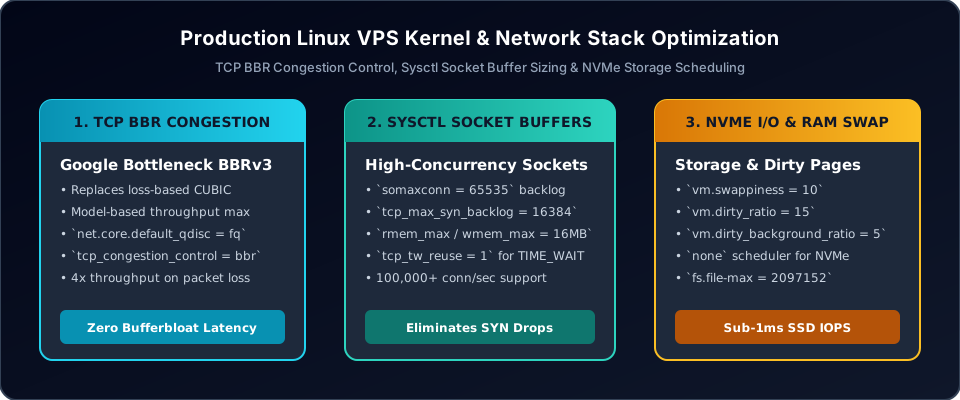
पारंपरिक TCP कंजेशन एल्गोरिदम (जैसे CUBIC) पैकेट लॉस को नेटवर्क कंजेशन के एकमात्र संकेतक के रूप में मानते हैं, जिससे ट्रांसअटलांटिक या सेलुलर कनेक्शन पर थ्रूपुट गिर जाता है। Google BBR (बॉटलनेक बैंडविड्थ और राउंड-ट्रिप प्रोपेगेशन टाइम) नेटवर्क पाइपलाइन का एक गतिशील भौतिक मॉडल बनाता है, जो कतार की देरी को लगभग शून्य रखते हुए थ्रूपुट को अधिकतम करता है।
# Enable Fair Queuing and BBR in /etc/sysctl.conf
net.core.default_qdisc = fq
net.ipv4.tcp_congestion_control = bbr
यह सत्यापित करने के लिए कि BBR चल रहे Linux कर्नेल में सक्रिय रूप से लोड है, निष्पादित करें:
sysctl net.ipv4.tcp_congestion_control
lsmod | grep bbr
2. उच्च-समवर्ती (High-Concurrency) सॉकेट बफर ट्यूनिंग
ट्रैफिक स्पाइक के दौरान कनेक्शन ड्रॉप को खत्म करने के लिए, सॉकेट लिसन बैकलॉग, कनेक्शन ट्रैकिंग सीमा और मेमोरी बफर आवंटन को विस्तृत करें /etc/sysctl.conf:
# Socket Backlogs
net.core.somaxconn = 65535
net.ipv4.tcp_max_syn_backlog = 16384
net.core.netdev_max_backlog = 16384

# TCP Buffer Allocations (Min / Default / Max in bytes)
net.ipv4.tcp_rmem = 4096 87380 16777216
net.ipv4.tcp_wmem = 4096 65536 16777216
net.core.rmem_max = 16777216
net.core.wmem_max = 16777216

# Socket Reuse & File Descriptors
net.ipv4.tcp_tw_reuse = 1
net.ipv4.tcp_fin_timeout = 15
fs.file-max = 2097152
ये मान सुनिश्चित करते हैं कि कर्नेल पीक समवर्तीता के तहत समय से पहले हैंडशेक समाप्त किए बिना या SYN पैकेट को गिराए बिना आने वाले HTTP/HTTPS कनेक्शन के बड़े बर्स्ट को बफर कर सकता है।
3. NVMe स्टोरेज I/O & मेमोरी स्वैपनेस
आधुनिक NVMe फ्लैश स्टोरेज के लिए, कर्नेल I/O कतार अनावश्यक CPU ओवरहेड जोड़ती है। ���्टोरेज शेड्यूलर को इस पर सेट करें none और डर्टी पेज फ्लशिंग को ट्यून करें:
# Virtual Memory & Swappiness Tuning
vm.swappiness = 10
vm.dirty_ratio = 15
vm.dirty_background_ratio = 5
vm.vfs_cache_pressure = 50
इसके माध्यम से रीबूट किए बिना तुरंत परिवर्तन लागू करें sudo sysctl -p. सॉलिड-स्टेट ड्राइव (SSD) और PCIe NVMe ब्लॉक डिवाइस के लिए, इसका निरीक्षण करके सक्रिय शेड्यूलर को सत्यापित करें:
cat /sys/block/nvme0n1/queue/schedulerआउटपुट संकेत देना चाहिए [none] या [mq-deadline] कम-ओवरहेड प्रत्यक्ष मल्टी-कतार हार्डवेयर प्रेषण सुनिश्चित करने के लिए।
4. Systemd & PAM फ़ाइल डि���्क्रिप्टर सीमाएँ (nofile)
उच्च-ट्रैफिक वेब इंस्टेंस पर एक सामान्य विफलता मोड कुख्यात socket: too many open files (errno 24) है। भले ही fs.file-max को sysctl में लाखों पर ट्यून किया गया हो, Linux प्रक्रियाएं PAM उपयोगकर्ता सीमाओं और Systemd सेवा इकाई सीमाओं द्वारा बाधित होती हैं।
इसमें लगातार सिस्टम-व्यापी सीमाएँ कॉन्फ़िगर करें /etc/security/limits.conf:
* soft nofile 65536
* hard nofile 1048576
root soft nofile 65536
root hard nofile 1048576
Systemd द्वारा प्रबंधित सेवाओं (जैसे Nginx, Redis, या Node.js) के लिए, सेवा इकाई ओवरराइड या संपादित करें /etc/systemd/system.conf:
[Service]
LimitNOFILE=65536
LimitNPROC=65536
के साथ systemd डेमॉन को पुनः लोड करें sudo systemctl daemon-reload और बढ़ी हुई फ़ाइल डिस्क्रिप्टर सीमाओं को लागू करने के लिए सेवा को पुनरारंभ करें।
5. Ethtool के साथ नेटवर्क इंटरफ़ेस ट्यूनिंग & रिंग बफर
भारी नेटवर्क I/O को संसाधित करने वाले वर्चुअल सर्वर इंस्टेंस आने वाले पैकेटों को कर्नेल नेटवर्क स्टैक तक पहुँचने से पहले गिरा सकते हैं यदि इंटरफ़ेस रिंग बफर डिफ़ॉल्ट रूढ़िवादी मानों पर सेट हैं।
उपयोग करें ethtool RX/TX रिंग बफर का निरीक्षण करने और उन्हें अधिकतम करने के लिए:
# Query maximum and current ring buffer sizes
sudo ethtool -g eth0

# Expand RX and TX ring buffers to device maximums
sudo ethtool -G eth0 rx 4096 tx 4096

# Verify hardware offloading features (TSO, GSO, GRO)
sudo ethtool -k eth0 | grep -E "tcp-segmentation-offload|generic-receive-offload"
TCP सेगमेंटेशन ऑफ़लोड (TSO) और जेनेरिक रिसीव ऑफ़लोड (GRO) सक्षम होने से नेटवर्क कार्ड को पैकेट एकत्र करने की अनुमति मिलती है, जिससे उच्च-थ्रूपुट वर्कलोड पर CPU रुकावटें काफी कम हो जाती हैं।
6. अनुभवजन्य बेंचमार्किंग & सत्यापन सुइट
परिवर्तन लागू करने से पहले और बाद में अनुभवजन्य परीक्षण के साथ कर्नेल अनुकूलन को मान्य करें। इन सत्यापित CLI टूल को निष्पादित करें:
# Test raw network throughput and latency across multiple TCP streams
iperf3 -c benchmark.winwinhost.com -P 8 -t 30

# Benchmark NVMe random 4K read/write IOPS and latency under direct I/O
fio --name=randwrite --ioengine=libaio --iodepth=64 --rw=randwrite \
    --bs=4k --direct=1 --size=2G --runtime=30 --numjobs=4 --group_reporting

# Monitor virtual memory, page faults, and context switches in real time
vmstat 1 10

# Audit disk I/O utilization and wait queues per device
iostat -xz 1 5
अक्सर पूछे जाने वाले प्रश्न
लंबे समय तक या पैकेट-लॉस वाले लिंक पर TCP BBR, Cubic से बेहतर क्यों है?
TCP Cubic यह मानता है कि पैकेट लॉस कंजेशन का संकेत देता है और पैकेट ड्रॉप होने पर ट्रांसमिशन विंडो को आधा कर देता है। ट्रांसअटलांटिक या वाई-फाई लिंक पर जहाँ मामूली पैकेट लॉस सामान्य है, Cubic नेटवर्क थ्रूपुट को भूखा रखता है। BBR लगातार वास्तविक राउंड-ट्रिप टाइम (RTT) और डिलीवरी दर को मापता है, 1-2% बैकग्राउंड पैकेट लॉस के साथ भी पूर्ण लाइन-रेट थ्रूपुट को बनाए रखता है।
vm.swappiness = 10 को 0 की तुलना में सेट करने से क्या होता है?
सेटिंग vm.swappiness = 0 आक्रामक रूप से स्वैपिंग को तब तक रोकता है जब तक कि सिस्टम पूरी तरह से रैम से बाहर न हो जाए, जो अचानक मेमोरी स्पाइक के दौरान कर्नेल आउट-ऑफ-मिश्रण (OOM) किलर को समय से पहले ट्रिगर कर सकता है। की एक सेटिंग 10 कर्नेल को फ़ाइल सिस्टम पेज कैश को पुनः प्राप्त करने को प्राथमिकता देने का निर्देश देता है, जबकि अभी भी स्वैप स्पेस को क्षणिक मेमोरी स्पाइक को सुरक्षित रूप से अवशोषित करने की अनुमति देता है।
मैं कैसे सत्यापित कर सकता हूँ कि sysctl कॉन्फ़िगरेशन कर्नेल रीबूट के बाद भी बने रहते हैं?
समर्पित ड्रॉप-इन फ़ाइलों में सभी कॉन्फ़िगरेशन संग्रहीत करें जैसे कि /etc/sysctl.d/99-custom-tuning.conf. जब सर्वर बूट होता है, systemd-sysctl.service में सभी फ़ाइलों को लोड करता है /etc/sysctl.d/ वर्णमाला के क्रम में, यह सुनिश्चित करते हुए कि डिफ़ॉल्ट वितरण पैकेज द्वारा मानों को ओवरराइट नहीं किया जाए।
मुझे स्टोरेज शेड्यूलिंग के लिए none के बजाय mq-deadline कब चुनना चाहिए?
हार्डवेयर मल्टी-क्वीनिंग सक्षम करने में सक्षम एंटरप्राइज़ PCIe 4.0/5.0 NVMe ड्राइव के लिए, none शेड्यूलर सबसे कम CPU ओवरहेड प्रदान करता है। साझा स्टोरेज सरणी वाले SATA SSD या虚拟कृत virtio ब्लॉक उपकरणों के लिए, mq-deadline सीमित पठन और लेखन अनुरोध समय सीमा को लागू करके I/O भुखमरी को रोकता है।
सारांश & उच्च-प्रदर्शन क्लाउड VPS
Linux कर्नेल को ट्यून करना एक मानक वर्चुअल इंस्टेंस को हजारों समवर्ती HTTP/HTTPS कनेक्शन को संभालने में सक्षम एक उच्च-समवर्ती इंजन में बदल देता है। Google BBR, विस्तारित सॉकेट बफर, ट्यून किए गए मेमोरी स्वैपिंग और उचित फ़ाइल डिस्क्रिप्टर सीमाओं को संयोजित करके, क्लाउड सर्वर उप-मिलीसेकंड प्रतिक्रिया समय के साथ अधिकतम थ्रूपुट प्राप्त करते हैं।
उच्च-प्रदर्शन NVMe क्लाउड सर्वर
WinWinHost पर PCIe 4.0 NVMe स्टोरेज, समर्पित CPU कोर और प्रीमियम टियर-1 नेटवर्क ट्रांजिट द्वारा संचालित ट्यून किए गए Linux क्लाउड इंस्टेंस को तैनात करें।
क्लाउड VPS योजनाएं देखें →