
Развертывание высокопроизводительного Linux VPS требует настройки параметров ядра, сетевых буферов и параметров файловой системы. В этом ��рактическом руководстве мы рассматриваем управление перегрузкой Google BBRv3, настройку размера буферов сокетов TCP, порогов подкачки виртуальной памяти и оптимизацию флеш-накопителей NVMe для производственных веб-серверов.
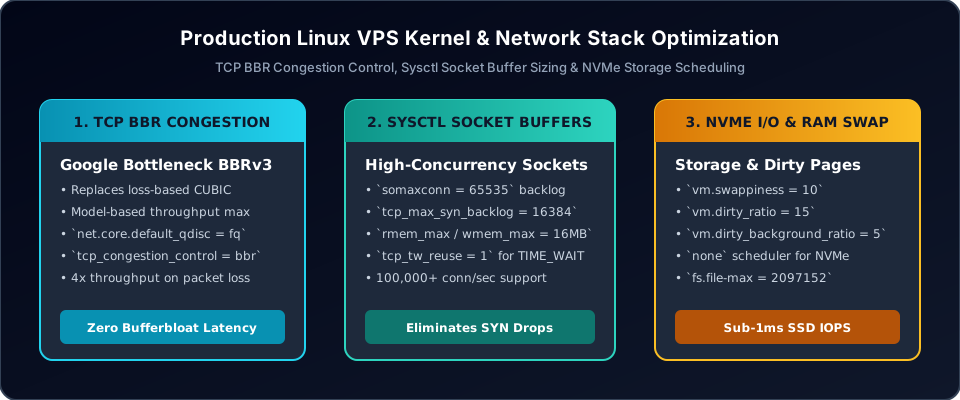
1. Активация управления перегрузкой Google BBRv3
Традиционные алгоритмы перегрузки TCP (такие как CUBIC) рассматривают потерю пакетов как единственный индикатор перегрузки сети, что приводит к падению пропускной способности при трансатлантических или сотовых соединениях. Google BBR (Bottleneck Bandwidth and Round-trip propagation time) строит динамическую физическую модель сетевого конвейера, максимизируя пропускную способность и удерживая задержки в очереди близкими к нулю.
# Enable Fair Queuing and BBR in /etc/sysctl.conf
net.core.default_qdisc = fq
net.ipv4.tcp_congestion_control = bbr
Чтобы убедиться, что BBR активно загружен в работающем ядре Linux, выполните:
sysctl net.ipv4.tcp_congestion_control
lsmod | grep bbr
2. Настройка буферов сокетов для высокой параллельности
Для исключения обрывов соединений при пиковых нагрузках увеличьте очередь ожидающих соединений (backlog) сокета, лимиты отслеживания соединений и распределение памяти буферов в /etc/sysctl.conf:
# Socket Backlogs
net.core.somaxconn = 65535
net.ipv4.tcp_max_syn_backlog = 16384
net.core.netdev_max_backlog = 16384

# TCP Buffer Allocations (Min / Default / Max in bytes)
net.ipv4.tcp_rmem = 4096 87380 16777216
net.ipv4.tcp_wmem = 4096 65536 16777216
net.core.rmem_max = 16777216
net.core.wmem_max = 16777216

# Socket Reuse & File Descriptors
net.ipv4.tcp_tw_reuse = 1
net.ipv4.tcp_fin_timeout = 15
fs.file-max = 2097152
Эти значения гарантируют, что ядро сможет буферизовать крупные всплески входящих соединений HTTP/HTTPS без преждевременного завершения рукопожатий (handshakes) или отбрасывания SYN-пакетов при пиковой параллельности.
3. Ввод-вывод хранилища NVMe & Подкачка памяти (Swappiness)
Для современных флеш-накопителей NVMe очередь ввода-вывода ядра создает излишнюю нагрузку на ЦП. Установите планировщик хранилища в значение none и настройте сброс грязных страниц (dirty pages):
# Virtual Memory & Swappiness Tuning
vm.swappiness = 10
vm.dirty_ratio = 15
vm.dirty_background_ratio = 5
vm.vfs_cache_pressure = 50
Примените изменения немедленно без перезагрузки с помощью sudo sysctl -p. Для твердотельных накопителей (SSD) и блочных устройств PCIe NVMe проверьте активный планировщик, проверив:
cat /sys/block/nvme0n1/queue/schedulerВывод должен указывать [none] или [mq-deadline] , чтобы обеспечить низкозатратную прямую многоочередную аппаратную диспетчеризацию.
4. Лимиты дескрипторов файлов Systemd & PAM (nofile)
Распространенная проблема на веб-серверах с высоким трафиком — печально известная ошибка socket: too many open files (errno 24). Даже если fs.file-max настроен на миллионы в sysctl, процессы Linux ограничены пользовательскими лимитами PAM и границами юнитов служб Systemd.
Настройте постоянные системные лимиты в /etc/security/limits.conf:
* soft nofile 65536
* hard nofile 1048576
root soft nofile 65536
root hard nofile 1048576
Для служб, управляемых Systemd (таких как Nginx, Redis или Node.js), отредактируйте переопределение юнита службы или /etc/systemd/system.conf:
[Service]
LimitNOFILE=65536
LimitNPROC=65536
Пе��езагрузите демон systemd с помощью sudo systemctl daemon-reload и перезапустите службу, чтобы применить увеличенные лимиты дескрипторов файлов.
5. Настройка сетевого интерфейса с помощью Ethtool & Кольцевые буферы (Ring Buffers)
Виртуальные серверы, обрабатывающие интенсивный сетевой ввод-вывод, могут отбрасывать входящие пакеты до того, как они достигнут сетевого стека ядра, если кольцевые буферы интерфейса установлены в стандартные консервативные значения.
Используйте ethtool для проверки и максимизации кольцевых буферов RX/TX:
# Query maximum and current ring buffer sizes
sudo ethtool -g eth0

# Expand RX and TX ring buffers to device maximums
sudo ethtool -G eth0 rx 4096 tx 4096

# Verify hardware offloading features (TSO, GSO, GRO)
sudo ethtool -k eth0 | grep -E "tcp-segmentation-offload|generic-receive-offload"
Включение разгрузки сегментации TCP (TSO) и общей разгрузки приема (GRO) позволяет сетевой карте агрегировать пакеты, значительно снижая прерывания ЦП при высоких нагрузках.
6. Набор эмпирического тестирования производительности & Верификация
Проверьте оптимизации ядра с помощью эмпирического тестирования до и после применения изменений. Запустите следующие проверенные инструменты командной строки:
# Test raw network throughput and latency across multiple TCP streams
iperf3 -c benchmark.winwinhost.com -P 8 -t 30

# Benchmark NVMe random 4K read/write IOPS and latency under direct I/O
fio --name=randwrite --ioengine=libaio --iodepth=64 --rw=randwrite \
    --bs=4k --direct=1 --size=2G --runtime=30 --numjobs=4 --group_reporting

# Monitor virtual memory, page faults, and context switches in real time
vmstat 1 10

# Audit disk I/O utilization and wait queues per device
iostat -xz 1 5
Часто задаваемые вопросы
Почему TCP BBR лучше, чем Cubic, на дальних расстояниях или в сетях с потерей пакетов?
TCP Cubic предполагает, что потеря пакетов указывает на перегрузку, и сокращает окно передачи вдвое при каждом падении пакета. На трансатлантических или Wi-Fi соединениях, где небольшие потери пакетов являются обычным делом, Cubic снижает пропускную способность сети. BBR постоянно измеряет фактическое время кругового пути (RTT) и скорость доставки, поддерживая максимальную линейную пропускную способность даже при фоновых потерях пакетов в 1-2%.
Что делает установка vm.swappiness = 10 по сравнению с 0?
Установка vm.swappiness = 0 агрессивно предотвращает подкачку до тех пор, пока оперативная память не закончится полностью, что может вызвать преждевременное срабатывание убийцы процессов OOM (Out-Of-Memory) ядра при резких скачках памяти. Настройка 10 предписывает ядру отдавать предпочтение очистке кэша страниц файловой ��истемы, позволяя пространству подкачки безопасно поглощать временные всплески памяти.
Как убедиться, что конфигурации sysctl сохраняются после перезагрузки ядра?
Сохраняйте все конфигурации в специализированных подключаемых файлах, таких как /etc/sysctl.d/99-custom-tuning.conf. При загрузке сервера systemd-sysctl.service загружает все файлы в /etc/sysctl.d/ в алфавитном порядке, гарантируя, что значения не будут перезаписаны пакетами дистрибутива по умолчанию.
Когда следует выбирать mq-deadline вместо none для планирования хранилища?
Для корпоративных накопителей PCIe 4.0/5.0 NVMe с поддержкой аппаратной многоочередности планировщик none обеспечивает минимальную нагрузку на ЦП. Для твердотельных накопителей SATA или виртуализированных блочных устройств virtio с общими массивами хранения mq-deadline предотвращает нехватку ввода-вывода за счет соблюдения ограниченных сроков выполнения запросов на чтение и запись.
Резюме & Высокопроизводительный облачный VPS
Настройка ядра Linux превращает стандартный виртуальный экземпляр в высокопараллельный механизм, способный обрабатывать десятки тысяч одновременных подключений HTTP/HTTPS. Сочетая Google BBR, расширенные буферы сокетов, настроенную подкачку памяти и правильные границы дескрипторов файлов, облачные се��веры достигают максимальной пропускной способности со временем отклика менее миллисекунды.
Высокопроизводительные облачные серверы NVMe
Развертывайте настроенные облачные инстансы Linux на базе хранилищ PCIe 4.0 NVMe, выделенных ядер ЦП и премиального сетевого транзита Tier-1 на WinWinHost.
Изучить тарифы Cloud VPS →