
部署高吞吐量 Linux VPS 需要调优内核参数、网络缓冲区和文件系统参数。在本操作指南中,我们回顾了 Google BBRv3 拥塞控制、TCP 套接字缓冲区大小调整、虚拟内存交换阈值以及生产 Web 服务器的 NVMe 闪存存储优化。
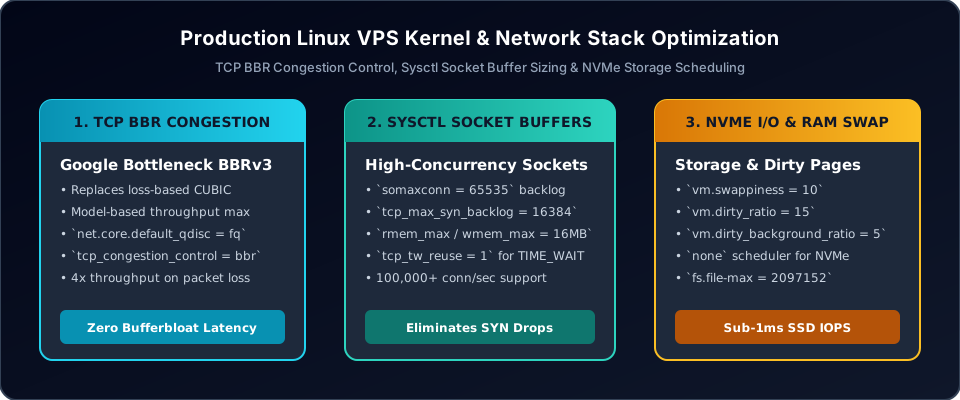
1. 激活 Google BBRv3 拥塞控制
传统的 TCP 拥塞算法(如 CUBIC)将丢包视为网络拥塞的唯一指标,导致跨大西洋或蜂窝连接的吞吐量崩溃。 Google BBR(瓶颈带宽和往返传播时间) 构建了网络管道的动态物理模型,在最大化吞吐量的同时将队列延迟保持在接近零的水平。
# Enable Fair Queuing and BBR in /etc/sysctl.conf
net.core.default_qdisc = fq
net.ipv4.tcp_congestion_control = bbr
要验证 BBR 是否已在运行的 Linux 内核中主动加载,请执行:
sysctl net.ipv4.tcp_congestion_control
lsmod | grep bbr
2. 高并发套接字缓冲区调优
为了消除流量激增期间的连接中断,请扩展套接字侦听积压队列、连接跟踪限制和内存缓冲区分配,位于 /etc/sysctl.conf:
# Socket Backlogs
net.core.somaxconn = 65535
net.ipv4.tcp_max_syn_backlog = 16384
net.core.netdev_max_backlog = 16384

# TCP Buffer Allocations (Min / Default / Max in bytes)
net.ipv4.tcp_rmem = 4096 87380 16777216
net.ipv4.tcp_wmem = 4096 65536 16777216
net.core.rmem_max = 16777216
net.core.wmem_max = 16777216

# Socket Reuse & File Descriptors
net.ipv4.tcp_tw_reuse = 1
net.ipv4.tcp_fin_timeout = 15
fs.file-max = 2097152
这些值确保内核可以缓冲大量传入的 HTTP/HTTPS 连接突发,而不会在峰值并发下提前终止握手或丢弃 SYN 数据包。
3. NVMe 存储 I/O 与 & 内存交换倾向(Swappiness)
对于现代 NVMe 闪存存储,内核 I/O 排队会增加不必要的 CPU 开销。将存储调度器设置为 none 并调优脏页刷新:
# Virtual Memory & Swappiness Tuning
vm.swappiness = 10
vm.dirty_ratio = 15
vm.dirty_background_ratio = 5
vm.vfs_cache_pressure = 50
通过以下方式立即应用更改而无需重启 sudo sysctl -p. 对于固态硬盘 (SSD) 和 PCIe NVMe 块设备,通过检查以下内容来验证活动调度器:
cat /sys/block/nvme0n1/queue/scheduler输出应指示 [none] 或 [mq-deadline] 以确保低开销的直接多队列硬件调度。
4. Systemd 与 & PAM 文件描述符限制 (nofile)
高流量 Web 实例上的一个常见故障模式是众所周知的 socket: too many open files (错误号 24)。即使 fs.file-max 在 sysctl 中调优到数百万,Linux 进程也会受到 PAM 用户限制和 Systemd 服务单元边界的约束。
在以下位置配置持久的系统级限制 /etc/security/limits.conf:
* soft nofile 65536
* hard nofile 1048576
root soft nofile 65536
root hard nofile 1048576
对于由 Systemd 管理的服务(例如 Nginx、Redis 或 Node.js),请编辑服务单元覆盖或 /etc/systemd/system.conf:
[Service]
LimitNOFILE=65536
LimitNPROC=65536
使用以下命令重新加载 systemd 守护进程 sudo systemctl daemon-reload 并重启服务以应用增加的文件描述符限制。
5. 使用 Ethtool 进行网络接口调优与 & 环形缓冲区(Ring Buffers)
如果接口环形缓冲区设置为默认的保守值,处理沉重网络 I/O 的虚拟服务器实例可能会在数据包到达内核网络栈之前将其丢弃。
使用 ethtool 检查并最大化 RX/TX 环形缓冲区:
# Query maximum and current ring buffer sizes
sudo ethtool -g eth0

# Expand RX and TX ring buffers to device maximums
sudo ethtool -G eth0 rx 4096 tx 4096

# Verify hardware offloading features (TSO, GSO, GRO)
sudo ethtool -k eth0 | grep -E "tcp-segmentation-offload|generic-receive-offload"
确保启用 TCP 分段卸载 (TSO) 和通用接收��载 (GRO) 允许网卡聚合数据包,从而在高吞吐量工作负载下显着降低 CPU 中断。
6. 经验基准测试与 & 验证套件
在应用更改前后通过实证测试验证内核优化。执行这些经过验证的 CLI 工具:
# Test raw network throughput and latency across multiple TCP streams
iperf3 -c benchmark.winwinhost.com -P 8 -t 30

# Benchmark NVMe random 4K read/write IOPS and latency under direct I/O
fio --name=randwrite --ioengine=libaio --iodepth=64 --rw=randwrite \
    --bs=4k --direct=1 --size=2G --runtime=30 --numjobs=4 --group_reporting

# Monitor virtual memory, page faults, and context switches in real time
vmstat 1 10

# Audit disk I/O utilization and wait queues per device
iostat -xz 1 5
常见问题解答
为什么 TCP BBR 在长距离或高丢包链路上优于 Cubic?
TCP Cubic 假设丢包表示拥塞,并且每当数据包丢失时就会将传输窗口减半。在微小丢包很常规的跨大西洋或 Wi-Fi 链路上,Cubic 会使网络吞吐量匮乏。BBR 持续测量实际往返时间 (RTT) 和交付速率,即使在有 1-2% 后台丢包的情况下也能维持全线速吞吐量。
与设置为 10 相比,设置 vm.swappiness = 0 有什么作用?
设置 vm.swappiness = 0 会激进地阻止交换,直到系统完全耗尽内存,这可能会在内存突然激增期间过早地���发内核内存不足 (OOM) 杀手。设置为 10 指示内核优先回收文件系统页面缓存,同时仍然允许交换空间安全地吸收瞬时内存峰值。
如何验证 sysctl 配置在内核重启后仍然持久存在?
将所有配置存储在专用的嵌入文件中,例如 /etc/sysctl.d/99-custom-tuning.conf. 当服务器启动时, systemd-sysctl.service 按字母顺序加载 /etc/sysctl.d/ 中的所有文件,确保值不会被默认发行版软件包覆盖。
什么时候应该选择 mq-deadline 而不是 none 作为存储调度?
对于能够进行硬件多队列的企业级 PCIe 4.0/5.0 NVMe 驱动器, none 调度器可提供最低的 CPU 开销。对于带有共享存储阵列的 SATA SSD 或虚拟化 virtio 块设备, mq-deadline 通过强制执行有界的读写请求死锁来防止 I/O 匮乏。
总结: & 高性能云 VPS
调优 Linux 内核可将标准的虚拟实例转变为能够处理数万个同时进行的 HTTP/HTTPS 连接的高并发引擎。通过结合 Google BBR、扩展的套接字缓冲区、调优的内存交换以及适当的文件描述符边界,云服务器能够以亚毫秒级的响应时间实现最大吞吐量。